Cuándo una empresa necesita un pipeline de datos y cuándo no
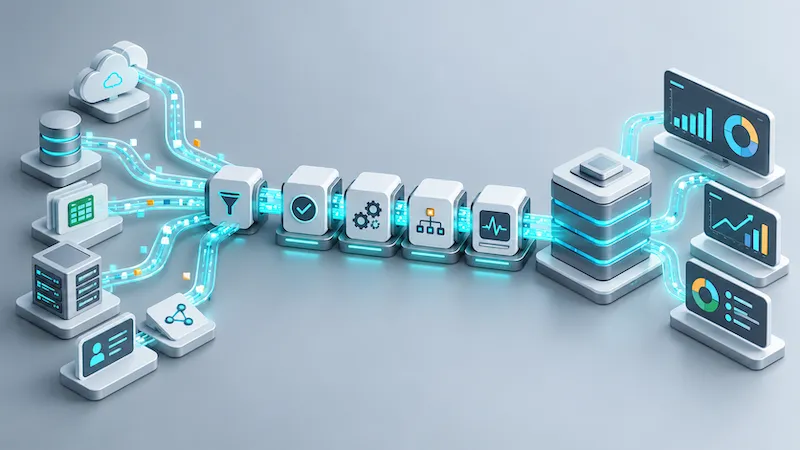
Muchas empresas tienen los datos que necesitan, pero no pueden utilizarlos a tiempo. La información está repartida entre hojas de cálculo, sistemas comerciales, bases de datos, archivos enviados por correo y APIs de terceros. Cada área prepara sus propios reportes y aplica reglas diferentes. Cuando los números finalmente coinciden, la decisión que debía apoyarse en ellos ya se retrasó.
En ese escenario surge una pregunta razonable: ¿hace falta construir un pipeline de datos? La respuesta depende menos del volumen que de la frecuencia, el riesgo y el costo operativo del proceso actual. Una empresa puede gestionar millones de registros con una solución sencilla si el flujo es estable y poco frecuente. Otra puede necesitar un pipeline con un volumen mucho menor si sus reportes diarios dependen de tareas manuales, formatos cambiantes y fuentes que no se actualizan al mismo tiempo.
Un pipeline se justifica cuando mover, validar y preparar información deja de ser una tarea ocasional y se convierte en una capacidad operativa que debe funcionar de forma repetible. Si el problema todavía puede resolverse con una consulta programada, un conector administrado o una automatización pequeña, construir una plataforma completa aumenta el costo y la carga de mantenimiento sin aportar control real.
Conclusión rápida
Una empresa necesita un pipeline cuando debe integrar datos de forma recurrente, aplicar reglas consistentes, detectar fallos y entregar información dentro de un plazo previsible. No lo necesita cuando el flujo es ocasional, de bajo riesgo y puede mantenerse con una solución más simple y comprensible.
Qué significa un pipeline de datos en términos empresariales
Un pipeline de datos es un proceso automatizado y repetible que obtiene información de una o varias fuentes, verifica su calidad y estructura, la transforma según reglas definidas y la entrega a un destino donde pueda utilizarse. Ese destino puede ser un almacén de datos, un panel de control, una aplicación operativa, un reporte o una API consumida por otro sistema.
La palabra importante es repetible. Descargar un archivo una vez para responder una pregunta no requiere una plataforma de datos. La necesidad aparece cuando la organización espera que el mismo flujo se ejecute periódicamente, produzca resultados consistentes y avise cuando los datos no cumplen las condiciones esperadas.
Desde la perspectiva del negocio, un pipeline debe cumplir cuatro responsabilidades:
- Obtener y mover los datos desde las fuentes correctas.
- Aplicar reglas de limpieza, normalización y transformación de forma consistente.
- Comprobar la calidad, actualidad y completitud de la información antes de utilizarla.
- Registrar cada ejecución y alertar sobre los fallos para que el equipo pueda investigar y recuperar el proceso.
La tecnología concreta se selecciona después. Python, SQL, BigQuery, DuckDB, MotherDuck o herramientas de orquestación pueden formar parte de la solución, pero ninguna sustituye la definición de las fuentes, las reglas, los responsables y el resultado que necesita la empresa.
Señales de que el proceso actual ya no es suficiente
El volumen de información no es la única señal para justificar un pipeline. También deben evaluarse la frecuencia del proceso, el trabajo manual requerido, las consecuencias de un error y la rapidez con la que el negocio necesita los resultados. Las siguientes situaciones ayudan a identificar cuándo una solución informal empieza a convertirse en un riesgo operativo.
La consolidación manual se repite
Cada semana, una persona descarga los mismos archivos, copia columnas entre hojas de cálculo, corrige fechas y combina resultados antes de actualizar un reporte. El procedimiento puede funcionar durante meses, pero depende de la disponibilidad, la memoria y la atención de quien lo ejecuta. Además, consume tiempo que podría dedicarse a analizar la información y tomar decisiones.
La repetición no significa que la empresa necesite inmediatamente una plataforma compleja. Sí indica que conviene documentar y automatizar el proceso. Si el resultado afecta la facturación, el inventario, las campañas, el cumplimiento o las decisiones diarias, también deben incorporarse validaciones, registros de ejecución y alertas ante fallos.
Los reportes no coinciden
Ventas presenta una cifra, finanzas otra y marketing una tercera. Cada número puede ser correcto dentro de su propia definición, periodo o filtro. El problema aparece cuando esas diferencias no están documentadas y nadie puede reproducir el cálculo.
Un pipeline bien diseñado centraliza las reglas o, cuando deben existir varias definiciones, las identifica de forma explícita. La meta no es forzar una única tabla para toda la empresa. Es saber de dónde proviene cada métrica, qué transformación recibió y quién es responsable de aprobarla.
La información vive en varios sistemas
CRM, ERP, plataforma de pagos, publicidad, analítica web, sistema interno y hojas de cálculo pueden describir partes distintas del mismo proceso. Para responder una pregunta aparentemente sencilla, el equipo debe unir identificadores, zonas horarias, monedas, nombres de clientes y estados que cada sistema representa de manera diferente.
Cuando esa integración es recurrente, una colección de exportaciones manuales se vuelve frágil. El pipeline permite separar la extracción de cada fuente, conservar los datos originales y aplicar reglas de correspondencia que puedan probarse y cambiarse.
Los errores se descubren tarde
Un dashboard puede verse normal aunque la API haya dejado de entregar una categoría, una columna cambie de tipo o falte un día completo. Si el primer aviso proviene de una reunión o de un cliente, el proceso necesita controles previos a la publicación.
Las validaciones pueden comprobar cantidades mínimas, campos obligatorios, unicidad, formatos, relaciones entre tablas y cambios inesperados de volumen. El objetivo no es garantizar que todos los datos sean perfectos. Es impedir que un fallo conocido se convierta silenciosamente en información oficial.
El tiempo de entrega ya afecta decisiones
Una empresa puede aceptar un reporte mensual preparado en dos días, pero no el mismo retraso para ajustar inventario o supervisar campañas activas. La frecuencia necesaria debe definirse a partir de la decisión, no de la posibilidad técnica de procesar todo en tiempo real.
Si el negocio necesita información a primera hora, el pipeline debe terminar antes de ese límite y alertar cuando no lo logra. Esa expectativa se convierte en un objetivo operativo verificable.
El conocimiento está concentrado en una persona
Algunos procesos funcionan porque alguien conoce el orden exacto de los archivos, recuerda qué filas excluir y sabe cómo reparar cada error. Mientras ese conocimiento no esté documentado y automatizado, el riesgo no depende del volumen de datos. Depende de la ausencia de un sustituto operativo.
Cuándo una solución sencilla es suficiente
La ingeniería responsable también consiste en saber cuándo no construir una plataforma. Un pipeline sofisticado requiere despliegues, credenciales, monitoreo, soporte, control de costos y personas capaces de responder cuando algo falla.
Una solución sencilla suele ser suficiente cuando se cumplen varias de estas condiciones:
- Existe una sola fuente estable y el proceso se ejecuta con poca frecuencia.
- El volumen cabe con margen en una herramienta conocida por el equipo.
- El resultado apoya un análisis puntual y no un proceso crítico de operación.
- La fuente ya ofrece un conector administrado que cubre los requisitos sin transformaciones complejas.
- Las reglas todavía están cambiando y el equipo necesita primero acordar qué significa cada métrica.
- No existe todavía una persona responsable de operar y revisar el flujo.
En estos casos puede bastar una consulta programada, un script pequeño, una función en la nube o una automatización bien documentada. La solución mínima debe incluir manejo de errores, registro de ejecución y una forma clara de volver a correr el proceso. Simple no significa invisible ni improvisado.
Marco de decisión para elegir la solución mínima
La arquitectura debe comenzar con la opción más sencilla que pueda cumplir los requisitos de confiabilidad, seguridad y tiempo de entrega. Solo conviene añadir complejidad cuando exista una necesidad operativa concreta.
1. El proceso utiliza un archivo ocasional
Empieza con: una plantilla, una consulta o un script ejecutado bajo demanda.
Conviene escalar cuando: el proceso se vuelve recurrente, afecta una operación importante o resulta difícil reproducir los mismos resultados.
2. Una fuente necesita actualizarse diariamente
Empieza con: una tarea programada que incluya validaciones básicas, manejo de errores y registro de cada ejecución.
Conviene escalar cuando: el proceso necesita reintentos automáticos, recuperación de periodos incompletos, dependencias entre tareas o varios consumidores.
3. Deben integrarse varias fuentes con reglas estables
Empieza con: un pipeline por lotes que conserve los datos originales, aplique transformaciones definidas y supervise la calidad del resultado.
Conviene escalar cuando: aumentan las fuentes, las dependencias, la frecuencia o la cantidad de procesos que utilizan los datos.
4. La operación requiere información con mayor rapidez
Empieza con: definir cuánto retraso puede aceptar realmente el negocio y evaluar si varias ejecuciones programadas durante el día son suficientes.
Conviene escalar cuando: responder en segundos o minutos produce un beneficio operativo medible. En ese caso puede justificarse una arquitectura basada en eventos o procesamiento en tiempo real.
5. Los equipos utilizan métricas diferentes
Empieza con: acordar las definiciones, los periodos, los filtros y las personas responsables de cada indicador.
Conviene escalar cuando: las reglas ya están aprobadas y necesitan aplicarse automáticamente de forma consistente. Automatizar antes de llegar a ese acuerdo solo reproduce la discrepancia con mayor rapidez.
6. El proceso no tiene un responsable definido
Empieza con: asignar quién revisará las ejecuciones, atenderá las alertas y aprobará los cambios.
Conviene escalar cuando: existe capacidad real para operar y mantener la solución. Ninguna herramienta elimina la necesidad de propiedad y soporte.
Anatomía de un pipeline mantenible
No todos los pipelines necesitan los mismos componentes, pero una arquitectura mantenible suele separar las responsabilidades para que cada fallo pueda identificarse y recuperarse.
Fuentes e ingesta
La ingesta obtiene datos de APIs, bases de datos, archivos, colas o aplicaciones internas. Debe respetar límites de las fuentes, guardar puntos de control y evitar duplicar información cuando una ejecución se repite. Las credenciales deben administrarse fuera del código.
Si los datos provienen de plataformas externas, la integración de APIs debe contemplar límites de uso, autenticación, paginación, cambios de estructura y mecanismos para recuperar ejecuciones incompletas.
Zona de datos originales
Conservar una copia controlada de los datos tal como llegaron permite investigar cambios y volver a procesar periodos anteriores. No siempre se necesita un data lake; el principio también puede aplicarse a un almacenamiento pequeño con nombres, fechas y permisos bien definidos.
Validación
Antes de transformar, el flujo debe comprobar el contrato básico de cada fuente. ¿Llegaron las columnas esperadas? ¿Las fechas son válidas? ¿El identificador principal está presente? ¿El volumen se aleja de su rango habitual? Las reglas deben distinguir entre errores que bloquean la publicación y advertencias que requieren revisión.
Transformación y modelo
La transformación corrige tipos, estandariza unidades, deduplica registros, calcula campos y relaciona entidades. El modelo final debe responder a decisiones concretas. Construir decenas de tablas sin consumidores definidos aumenta la superficie de mantenimiento.
Entrega
Los datos pueden entregarse a un dashboard, una tabla analítica, una aplicación, un archivo o una API. Cada consumidor necesita conocer la frecuencia, las condiciones de disponibilidad y el significado de los campos que utiliza.
Observabilidad y recuperación
El pipeline debe registrar inicio, fin, duración, cantidad de registros y motivo de fallo. También necesita reintentos controlados y una ruta para recuperar ejecuciones incompletas. Un flujo que funciona únicamente cuando todo sale bien sigue siendo un proceso frágil.
ETL y ELT sin convertir la sigla en la decisión
En un proceso ETL, los datos se extraen, se transforman y después se cargan en el destino. En ELT, se extraen, se cargan primero y se transforman dentro del sistema analítico. Ambas estrategias son válidas y ninguna es automáticamente superior.
La elección depende de la sensibilidad de la información, la capacidad del sistema de destino, los costos de procesamiento, la necesidad de conservar los datos originales y el lugar donde el equipo pueda probar y mantener mejor las reglas.
Un mismo flujo también puede combinar ambos enfoques. Por ejemplo, puede validar y anonimizar información sensible antes de cargarla y realizar el modelado analítico después. La arquitectura debe explicar por qué cada transformación ocurre en un punto específico, en lugar de seleccionar una sigla por tendencia o preferencia tecnológica.
Ejemplo de arquitectura para datos fragmentados
Pensemos en una empresa que necesita consolidar información de ventas, pagos, publicidad y operaciones. Los datos provienen de un ERP, un CRM, plataformas publicitarias y archivos enviados periódicamente por proveedores.
Un pipeline para este escenario podría funcionar de la siguiente manera:
- Cada conector obtiene únicamente los cambios producidos desde la última ejecución confirmada y conserva una copia de la respuesta original.
- La etapa de validación comprueba la estructura, las fechas, los identificadores y el volumen recibido antes de continuar.
- Las transformaciones normalizan clientes, campañas, monedas y periodos mediante reglas documentadas y versionadas.
- El repositorio analítico mantiene separados los datos originales, los datos preparados y los modelos listos para ser utilizados.
- Los paneles de control consultan modelos estables, en lugar de combinar directamente las fuentes dentro de cada visualización.
- El monitoreo alerta cuando una fuente no se actualiza, una validación falla o el proceso no termina dentro del horario acordado.
Para una operación pequeña, esta arquitectura puede implementarse con tareas programadas en Python y un motor analítico como DuckDB. Cuando existen varios colaboradores, mayores volúmenes o más consumidores, puede utilizarse un almacén administrado como BigQuery o MotherDuck junto con una herramienta de orquestación.
La selección debe responder al volumen real, la frecuencia, el presupuesto y la capacidad del equipo para operar la solución. La popularidad de una plataforma no es una razón suficiente para incorporarla.
Cuando la organización necesita integrar varias fuentes, establecer controles de calidad y entregar información confiable de forma recurrente, un servicio de ingeniería de datos puede ayudar a diseñar el flujo, seleccionar la arquitectura adecuada y definir cómo será operado.
Calidad de datos que puede verificarse
La calidad no debe reducirse a confirmar que el proceso terminó. Un pipeline puede ejecutar todas sus tareas sin errores técnicos y aun así publicar información incompleta, desactualizada o incorrecta.
Las comprobaciones más útiles suelen cubrir:
- Actualidad: los datos corresponden al periodo que el consumidor espera.
- Completitud: llegaron todos los archivos, periodos o registros obligatorios.
- Unicidad: los identificadores que deben ser únicos no aparecen duplicados.
- Validez: las fechas, cantidades, estados y códigos cumplen los formatos y rangos definidos.
- Integridad referencial: las relaciones esenciales entre registros pueden resolverse.
- Reconciliación: las cantidades y los totales coinciden con la fuente dentro de una tolerancia acordada.
- Variación: los cambios inesperados de volumen o distribución generan una alerta.
Cada regla necesita un responsable y una acción definida. Una alerta que nadie atiende no protege la información, pero un bloqueo innecesario también puede retrasar la operación.
Por esa razón, conviene separar los controles en tres grupos: errores que detienen la publicación, advertencias que permiten continuar y métricas utilizadas para observar tendencias.
Propiedad y documentación
El pipeline debe poder mantenerse sin depender exclusivamente de la memoria de quien lo construyó. Como mínimo, la documentación debería incluir:
- Las fuentes de datos y sus responsables de negocio.
- Los permisos necesarios y el procedimiento para rotar las credenciales, sin registrar secretos directamente en el documento.
- La estructura y el significado de los campos principales.
- Las reglas de transformación y las decisiones arquitectónicas.
- La frecuencia esperada y las ventanas de ejecución.
- El procedimiento para reiniciar, recuperar y reprocesar información.
- Las alertas existentes y las personas responsables de atenderlas.
- Los costos operativos y los límites que requieren revisión.
La documentación también protege la propiedad del sistema. La organización debe entender cómo se mueven sus datos, dónde se almacenan y qué necesita para mantener la solución si cambia el proveedor o el equipo responsable.
Costos que deben evaluarse antes de construir
El costo de un pipeline no termina cuando el primer reporte funciona. La evaluación debe considerar el desarrollo, la infraestructura, el almacenamiento, la transferencia de datos, el monitoreo, el soporte, los cambios en las APIs, las correcciones de calidad y la capacitación del equipo.
La complejidad aumenta cuando se incorporan herramientas que resuelven problemas que la empresa todavía no tiene. Un orquestador distribuido, el procesamiento en tiempo real y varias capas de almacenamiento pueden ser apropiados para una operación exigente. En un flujo diario con pocas fuentes, pueden convertir una automatización manejable en una plataforma difícil de sostener.
Una decisión útil compara el costo total de la solución con el costo actual del trabajo manual, los errores, los retrasos, los reprocesos y las decisiones tomadas con información incompleta. Si el beneficio no puede explicarse en esos términos, probablemente todavía falta definir el problema.
Cómo implementar sin sobredimensionar
Una implementación gradual permite comprobar el valor antes de ampliar la arquitectura:
- Define qué decisión necesita los datos y cuál es el plazo máximo para recibirlos.
- Documenta el proceso actual, incluidos los pasos manuales y las excepciones conocidas.
- Selecciona un flujo con valor claro y suficiente estabilidad para utilizarlo como piloto.
- Define la estructura esperada de las fuentes, las reglas de calidad y los criterios de aceptación.
- Construye el recorrido mínimo desde la fuente hasta un consumidor real.
- Ejecuta temporalmente el proceso nuevo en paralelo con el anterior y compara los resultados.
- Documenta la operación, la recuperación, los responsables y los costos antes de retirar el proceso anterior.
- Amplía la arquitectura únicamente cuando aparezcan nuevas necesidades verificadas.
Este enfoque reduce el riesgo y evita que la primera versión intente integrar todas las fuentes de la organización antes de demostrar que el modelo funciona.
Lista para una evaluación inicial
Antes de seleccionar herramientas o estimar una implementación, conviene responder estas preguntas:
- ¿Cuáles son las fuentes y quiénes consumirán los datos?
- ¿Cuánto tiempo se dedica a descargar, limpiar y consolidar información?
- ¿Qué errores ocurren con frecuencia y cuál es su impacto?
- ¿Con qué frecuencia se necesitan realmente los resultados?
- ¿Cuánto retraso puede aceptar la operación?
- ¿Qué significan las métricas críticas y quién las aprueba?
- ¿Qué información es sensible y qué permisos requiere?
- ¿Existe un conector o una automatización sencilla que ya resuelva el problema?
- ¿Qué validaciones y alertas necesita el proceso?
- ¿Cómo se recuperará una ejecución incompleta?
- ¿Cuánto costarán el desarrollo, la infraestructura, el soporte y la capacitación?
- ¿Qué flujo puede funcionar como piloto con un resultado verificable?
No es necesario contar con todas las respuestas desde el primer día. Sin embargo, las preguntas que permanezcan abiertas deben reconocerse como riesgos o decisiones pendientes.
Cuándo conviene buscar apoyo especializado
El apoyo especializado puede ser útil cuando varias áreas dependen del proceso, las fuentes cambian con frecuencia, existe información sensible o el equipo no tiene capacidad para diseñar y operar el flujo.
Una evaluación responsable debe comenzar por las decisiones que necesitan los datos, las fuentes disponibles, las reglas de negocio y los riesgos operativos. Las herramientas se seleccionan después.
Cooltimedia desarrolla soluciones de ingeniería de datos e integración de APIs para organizaciones que necesitan consolidar información, automatizar procesos y mantener el control de su arquitectura. La colaboración puede comenzar con un flujo específico y ampliar el alcance únicamente después de comprobar su funcionamiento.
¿Tu equipo invierte demasiado tiempo reuniendo datos antes de poder analizarlos? Revisemos las fuentes, la frecuencia, los riesgos y la decisión que necesita esa información. Con ese mapa podemos determinar si conviene implementar un pipeline, una integración puntual o una automatización más sencilla. Conversemos sobre tu flujo de datos.
Preguntas frecuentes
¿Excel deja de servir cuando una empresa necesita un pipeline?
No necesariamente. Excel puede seguir siendo una herramienta útil para revisar, analizar o presentar información. El problema aparece cuando se utiliza como mecanismo principal para integrar fuentes, aplicar reglas críticas y conservar un historial sin controles de versión o validaciones.
Un pipeline puede preparar datos confiables y entregar un archivo que el equipo continúe utilizando en Excel.
¿Cuál es la diferencia entre una automatización y un pipeline de datos?
Una automatización ejecuta una tarea sin intervención manual. Un pipeline organiza diferentes etapas para obtener, validar, transformar y entregar datos.
Un script programado puede considerarse un pipeline pequeño si cumple esas responsabilidades y cuenta con controles adecuados para detectar errores y recuperar ejecuciones incompletas.
¿Es mejor ETL o ELT?
No existe una respuesta universal. ETL puede ser conveniente cuando la información debe limpiarse, validarse o protegerse antes de entrar al sistema de destino.
ELT puede aprovechar la capacidad de un almacén analítico y conservar los datos originales para realizar nuevas transformaciones. La decisión debe considerar la seguridad, el costo, la capacidad técnica y la facilidad de mantenimiento.
¿Todos los pipelines deben funcionar en tiempo real?
No. El procesamiento en tiempo real añade complejidad y costo. Si una decisión se toma una vez al día, un proceso por lotes que termine de manera confiable antes de la hora requerida suele ser suficiente.
La frecuencia debe definirse a partir de la necesidad operativa, no de la posibilidad técnica de procesar los datos continuamente.
¿Cuánto cuesta implementar un pipeline de datos?
Depende de la cantidad y estabilidad de las fuentes, la frecuencia, el volumen, las reglas de calidad, los requisitos de seguridad, las herramientas existentes y el nivel de soporte necesario.
La evaluación debe dividir el trabajo por flujos y comparar el costo de la solución con el trabajo manual, los errores y el riesgo que reemplazará.
¿Cuánto tiempo toma construirlo?
Un flujo pequeño con fuentes estables puede validarse con rapidez. Una plataforma que integra sistemas heredados, información sensible y varios consumidores requiere más descubrimiento, coordinación y pruebas.
Conviene estimar la implementación por etapas y comenzar con un recorrido completo desde una fuente hasta un consumidor real.
¿Cómo se protege la información sensible?
La arquitectura debe aplicar el principio de menor privilegio, cifrado durante la transferencia y el almacenamiento, separación de ambientes, gestión segura de credenciales, controles de retención y registros de acceso.
Cuando sea posible, los datos personales deben minimizarse, anonimizarse o excluirse de las capas analíticas que no los necesitan.
Jair Manuel Poveda Frago
Python & Django Engineer
Desarrollador Python y Django, fundador de Cooltimedia y profesor universitario. Especialista en arquitectura de software, IA y soluciones de datos. Conecto la ingeniería aplicada en proyectos reales con la docencia universitaria, compartiendo aprendizajes sobre desarrollo profesional, automatización y buenas prácticas de ingeniería.