Del dato crudo a una decisión confiable: cinco funciones de un data engineer
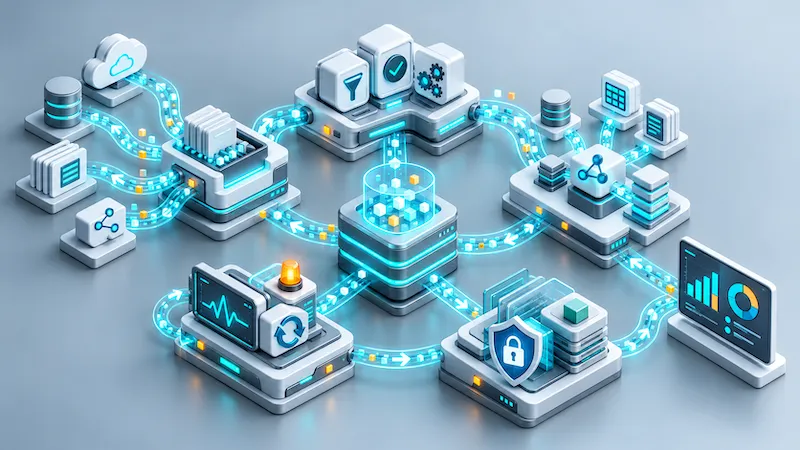
Una empresa puede tener información en su CRM, ERP, plataformas de pago, campañas publicitarias, archivos internos y aplicaciones operativas. Sin embargo, disponer de datos no significa que estén listos para apoyar una decisión.
Antes de llegar a un reporte o panel de control, la información debe extraerse, almacenarse, validarse, transformarse, documentarse y entregarse de manera confiable. Además, todo ese proceso debe seguir funcionando cuando una fuente cambia, una ejecución falla o aumenta el número de consumidores.
Ese recorrido resume una parte importante del trabajo de un data engineer. Su función no consiste únicamente en trasladar datos entre sistemas, sino en convertir ese movimiento en una capacidad operativa que la organización pueda entender, controlar y mantener.
1. Llevar los datos al lugar donde pueden utilizarse
La primera responsabilidad consiste en obtener información desde las fuentes correctas y trasladarla hacia un entorno donde pueda procesarse con seguridad.
Las fuentes pueden incluir APIs, bases de datos, aplicaciones internas, archivos, sistemas heredados o servicios en la nube. La ingesta debe considerar autenticación, límites de uso, paginación, actualizaciones incrementales y posibles interrupciones.
Cuando las fuentes son plataformas externas, una integración de APIs confiable debe contemplar autenticación, paginación, límites de uso, cambios de estructura y recuperación de ejecuciones incompletas.
Mover los datos no significa simplemente copiar todo en cada ejecución. Un proceso confiable debe saber qué información ya fue recibida, qué cambió desde la última ejecución y cómo evitar duplicados si una tarea necesita repetirse.
También conviene conservar una copia controlada de los datos originales. Esto permite investigar cambios en la fuente, corregir transformaciones y reprocesar periodos anteriores sin depender de una nueva descarga.
2. Convertir los datos en información utilizable
Los datos originales rara vez llegan en condiciones de utilizarse directamente. Las fechas pueden emplear formatos diferentes, los clientes pueden tener varios identificadores y una misma moneda puede aparecer representada de distintas maneras.
El data engineer implementa reglas para corregir tipos, normalizar valores, eliminar duplicados, resolver relaciones y comprobar que la información cumpla las condiciones esperadas.
Esta etapa también incluye validaciones:
- ¿Llegaron todas las columnas obligatorias?
- ¿Los identificadores principales están presentes?
- ¿Las fechas y cantidades utilizan formatos válidos?
- ¿El volumen recibido se encuentra dentro de un rango razonable?
- ¿Falta algún archivo, periodo o categoría importante?
Las reglas técnicas no deberían inventar definiciones empresariales. Conceptos como cliente activo, venta confirmada o campaña rentable deben acordarse con las personas responsables del negocio. El trabajo de ingeniería consiste en aplicar esas definiciones de forma consistente y verificable.
3. Añadir valor y entregar datos preparados
Un pipeline no debe limitarse a trasladar y limpiar información. También puede combinar fuentes para producir una representación más útil del negocio.
Por ejemplo, los datos de un CRM pueden relacionarse con pagos, campañas publicitarias y actividad operativa. Esta combinación permite construir métricas que ninguna fuente podría producir por sí sola.
El enriquecimiento puede incluir:
- Relacionar clientes entre diferentes sistemas.
- Clasificar transacciones o productos.
- Estandarizar ubicaciones, monedas y periodos.
- Incorporar categorías o atributos de referencia.
- Calcular métricas derivadas previamente acordadas.
- Preparar modelos específicos para ventas, finanzas u operaciones.
Después, la información debe ponerse a disposición de sus consumidores. El destino puede ser un panel de control, un almacén analítico, una aplicación, un archivo o una API.
La entrega debe incluir una definición clara de la frecuencia, el significado de los campos y las condiciones bajo las cuales los datos se consideran disponibles.
4. Administrar los datos responsablemente
La ingeniería de datos también incluye decisiones sobre seguridad, privacidad, documentación y gobierno.
No todas las personas deberían acceder a toda la información. Los permisos deben responder a responsabilidades reales y aplicar el principio de menor privilegio. Los datos sensibles deben protegerse durante su transferencia y almacenamiento, y excluirse de los entornos donde no sean necesarios.
La administración también debe permitir responder preguntas básicas:
- ¿De dónde proviene este dato?
- ¿Qué transformaciones recibió?
- ¿Quién es responsable de su definición?
- ¿Qué equipos o reportes lo utilizan?
- ¿Cuánto tiempo debe conservarse?
- ¿Qué ocurriría si la fuente deja de estar disponible?
El catálogo, la documentación y el seguimiento del origen de los datos no son tareas administrativas separadas del pipeline. Son parte de lo que permite investigar un error, evaluar un cambio y transferir el sistema a otro equipo.
5. Convertir el pipeline en una capacidad de producción
Un proceso que funciona manualmente en la computadora de quien lo desarrolló todavía no es una capacidad operativa.
Llevar un pipeline a producción implica automatizar su ejecución, administrar dependencias, registrar resultados y responder cuando algo falla. También requiere documentación que permita operar el flujo sin depender exclusivamente de su creador.
Como mínimo, un pipeline en producción debería registrar:
- Cuándo comenzó y terminó cada ejecución.
- Cuántos registros recibió y procesó.
- Qué validaciones se completaron.
- Qué tarea falló y por qué.
- Qué ejecuciones pueden repetirse de forma segura.
- Quién debe recibir una alerta.
- Cómo recuperar datos incompletos.
El monitoreo no consiste únicamente en saber si el proceso se ejecutó. También debe detectar si una fuente dejó de actualizarse, si el volumen cambió inesperadamente o si los resultados llegaron demasiado tarde para la decisión que debían apoyar.
El valor está en el recorrido completo
Estas cinco responsabilidades forman un mismo sistema. No sirve almacenar datos que nadie puede interpretar, transformar información sin controlar su origen o construir métricas que dejan de actualizarse silenciosamente.
Un data engineer conecta esas responsabilidades para que los datos lleguen, puedan utilizarse, adquieran valor, permanezcan controlados y funcionen de manera confiable en producción.
La herramienta concreta puede cambiar según el volumen, la frecuencia y el presupuesto. Lo importante es que la arquitectura resuelva el recorrido completo sin introducir más complejidad de la necesaria.
Convierte datos dispersos en un proceso confiable
¿Tu equipo dedica demasiado tiempo a extraer, corregir y combinar información antes de poder analizarla? Cooltimedia puede ayudarte a evaluar las fuentes, las reglas, los riesgos y la operación necesaria para convertir ese proceso en una solución mantenible.
Preguntas frecuentes
¿Cuál es la diferencia entre un data engineer y un data analyst?
El data engineer construye y mantiene los procesos que recopilan, validan, transforman y entregan la información. El data analyst utiliza esa información para estudiar resultados, encontrar patrones y apoyar decisiones. Ambos roles colaboran, pero resuelven partes diferentes del recorrido.
¿Un data engineer también crea dashboards?
Puede participar en la definición de los modelos y métricas que alimentan un dashboard, pero su responsabilidad principal suele estar en la infraestructura, calidad y disponibilidad de los datos. La visualización puede corresponder a un analista, especialista de BI u otro integrante del equipo.
¿Todos los pipelines requieren herramientas complejas?
No. Un pipeline pequeño puede implementarse mediante un script programado si incluye validación, registro, manejo de errores y recuperación. La complejidad debe responder a los requisitos operativos, no al nombre o popularidad de una herramienta.
Jair Manuel Poveda Frago
Python & Django Engineer
Desarrollador Python y Django, fundador de Cooltimedia y profesor universitario. Especialista en arquitectura de software, IA y soluciones de datos. Conecto la ingeniería aplicada en proyectos reales con la docencia universitaria, compartiendo aprendizajes sobre desarrollo profesional, automatización y buenas prácticas de ingeniería.